Để lại thông tin, chuyên gia Content Chuẩn SEO sẽ gọi lại tư vấn chiến lược SEO & Content trong 5 phút!
CHIẾN LƯỢC CONTENT SEO
GEMINI 4 ARGON: PHÂN TÍCH KỸ THUẬT VÀ VIỆC TỐI ƯU CHI PHÍ DOANH NGHIỆP
Đội Ngũ Chuyên Gia SEO IDEEN
01/10/2026
11 lượt đọc
5.0/5 (68 đánh giá)
Gemini 4 Argon vừa được Google giới thiệu nhằm giải quyết trực diện các tác vụ tự động hóa quy trình đòi hỏi chuỗi lập luận kéo dài và kỹ nghệ phần mềm chuyên sâu. Dữ liệu vận hành thực tế tại các trung tâm dữ liệu cho thấy những rào cản cố hữu về giới hạn token đầu ra và chi phí gọi API lặp vòng đang bóp nghẹt biên lợi nhuận của các hệ thống agentic tự hành. Việc duy trì tính toàn vẹn của mã nguồn qua hàng chục lượt suy luận trung gian đòi hỏi một bước nhảy vọt về năng lực xử lý thay vì chỉ mở rộng kích thước tham số. Sự xuất hiện của mô hình thiết lập một bài kiểm tra khắc nghiệt giữa năng lực suy luận dài hạn trong phòng thí nghiệm và hiệu quả kinh tế trên môi trường sản xuất.
Gemini 4 Argon Là Gì?
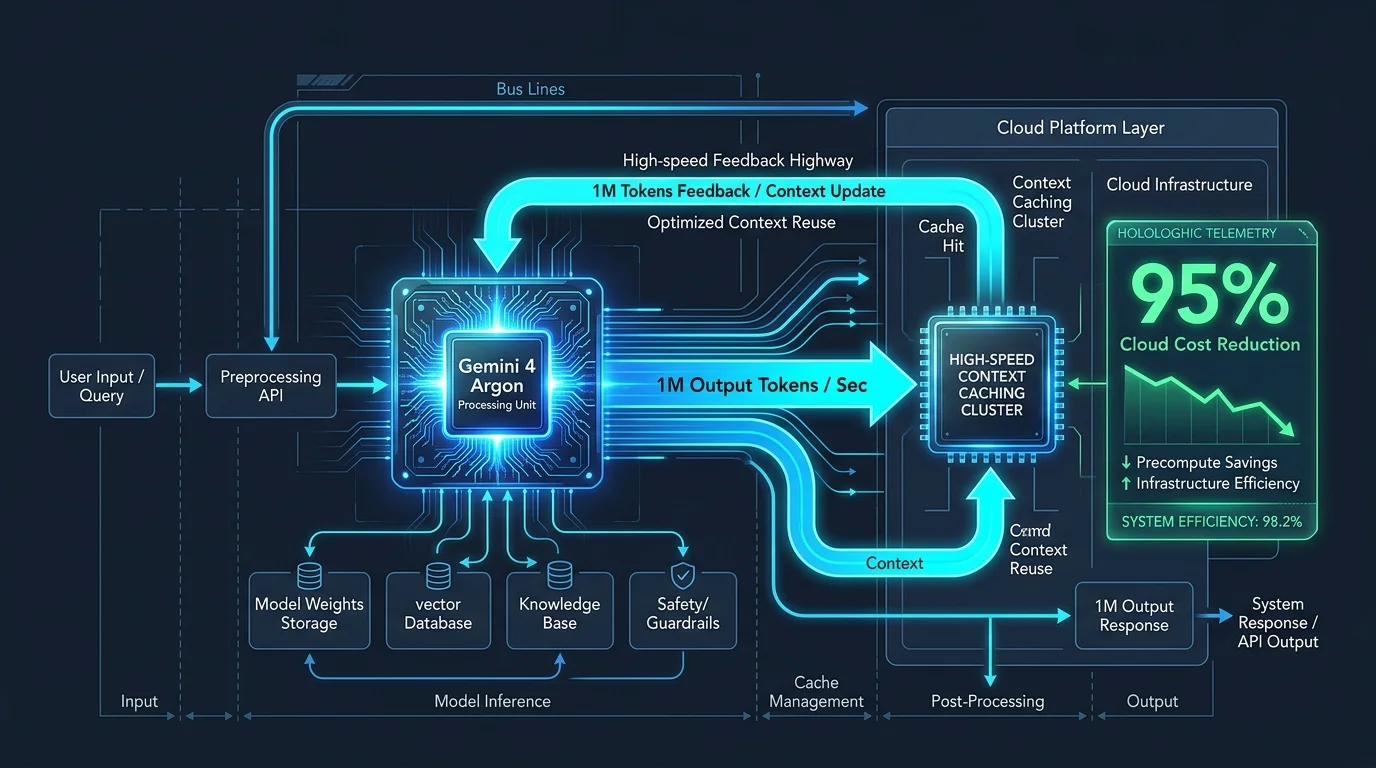
Gemini 4 Argon là mô hình trí tuệ nhân tạo frontier được thiết kế chuyên biệt cho chuỗi lập luận phức tạp của Google. Gemini 4 mở rộng dung lượng đầu ra lên 1 triệu token, tích hợp chiết khấu 95% dữ liệu đệm và xử lý đa phương thức nguyên bản, giảm triệt để sự đứt gãy ngữ cảnh trong luồng tự động hóa.
Sơ đồ khối luồng dữ liệu 1 triệu token đầu ra của Gemini 4 Argon giúp duy trì quỹ đạo suy luận
Thông Số Đo Kiểm Kỹ Thuật Giữa Gemini 4 Argon Và Các Nền Tảng Đối Thủ
Hiệu năng của các hệ thống AI phục vụ doanh nghiệp không thể đo đạc bằng những câu hỏi đối đáp thông thường. Khi đưa vào môi trường tính toán tự động, khả năng giữ vững mạch xử lý logic và dung lượng phản hồi quyết định trực tiếp khả năng sống còn của ứng dụng.
Tiêu chuẩn kỹ thuật
Gemini 4 Argon
OpenAI GPT-6 Astra
Claude Opus 5.5
Dung lượng đầu ra tối đa (Output)
1.000.000 token
128.000 Token
128.000 Token
Tỷ lệ chính xác CWE-bench v1
68,0%
68,0%
64,2%
Zapier AutomationBench
51,3%
41,4%
46,8%
Độ chính xác video dài (LVBench)
91,7%
84,5%
82,1%
Chiết khấu dữ liệu đệm (Cached Input)
95%
50% - 80%
90%
Đơn giá token đầu ra cơ sở
$10 - $20 / 1M token
$15 / 1M token
$25 / 1M token
khả năng xuất 1 triệu token duy trì quỹ đạo suy luận liên tục
Đột phá lớn nhất về mặt tính toán của Gemini 4 Argon nằm ở khả năng sinh tối đa 1 triệu token đầu ra trong một lần gửi yêu cầu duy nhất. Trước đây, mức trần 64.000 hoặc 128.000 token buộc các kỹ sư hệ thống phải chia nhỏ tác vụ, xây dựng các module trung gian để chắp vá các tệp mã nguồn lớn. Quy trình chia tách này liên tục làm mất dấu các biến môi trường và gây sai lệch cấu trúc dữ liệu nghiêm trọng. Việc giữ thông suốt toàn bộ chuỗi lập luận giúp tiến trình phân tích toàn bộ một kho lưu trữ phần mềm diễn ra liền mạch mà không bị phân mảnh.
độ chính xác xử lý đa phương thức trên tập dữ liệu quy mô lớn
Kết quả đo lường đạt 91,7% trên thang đo LVBench minh chứng khả năng giải mã video và đồ thị kỹ thuật dài hạn vượt trội. Không sử dụng các mô hình chuyển đổi văn bản phụ trợ, nền tảng phân tích trực tiếp luồng hình ảnh và biểu đồ tài chính với mật độ điểm ảnh phức tạp. Cơ chế xử lý tín hiệu trực tiếp từ định dạng gốc ngăn chặn tình trạng thất thoát thông tin qua các bước tiền xử lý.
Năng Lực Vận Hành Thực Tế Gemini 4 Argon: Đo Kiểm CWE-bench Và Quy Trình Tự Động Hóa
Kiểm thử mức độ tin cậy trong môi trường thực địa đòi hỏi AI phải trực tiếp can thiệp vào các tệp mã nguồn có sẵn, phát hiện lỗ hổng và vượt qua các bộ kiểm thử đơn vị nghiêm ngặt.
[Kho mã nguồn thực tế] ──> [Đọc bộ nhớ đệm Context Cache] ──> [Chuỗi suy luận dài hạn] │ ▼ [Vá lỗi bảo mật CWE-bench] <── [Tự động chạy Unit Test] <── [Sinh mã nguồn 1M token]
khả năng vá lỗi mã nguồn và chuyển đổi ngôn ngữ hệ thống
Mức điểm 68% trên bài kiểm tra CWE-bench v1 đưa mô hình ngang hàng với GPT-6 Astra trong các bài toán sửa lỗi phần mềm thực tế. Thay vì chỉ viết các hàm mẫu riêng lẻ, mô hình định vị chính xác vị trí rò rỉ bộ nhớ trong các hệ thống lớn. Các dự án nội bộ đã ứng dụng nền tảng này vào công tác tối ưu hóa bộ nhớ cụm máy chủ và hỗ trợ chuyển đổi mã nguồn từ C/C++ sang Rust mà vẫn bảo toàn quy chuẩn an toàn bộ nhớ.
khoảng cách giữa bảng xếp hạng phòng thí nghiệm và môi trường máy chủ
Cộng đồng kỹ thuật cần giữ sự thận trọng cần thiết trước các bảng số liệu do nhà sản xuất công bố. Các bài kiểm tra nội bộ luôn được cấp phát tài nguyên tính toán ở mức tối đa cùng các bộ khung điều phối được tinh chỉnh hoàn hảo. Khi đưa vào môi trường sản xuất thực tế, độ trễ mạng và ngân sách tính toán bị giới hạn sẽ tạo ra độ lệch đáng kể về tỷ lệ hoàn thành tác vụ.
Bài Toán Tối Ưu Chi Phí Cho Doanh Nghiệp Từ Cơ Chế Caching Của Gemini 4 Argon
Đối với một Giám đốc công nghệ, năng lực kỹ thuật phải luôn đi đôi với bài toán dòng tiền hạ tầng. Một hệ thống AI vận hành xuất sắc nhưng làm thâm hụt ngân sách điện toán đám mây sẽ không thể tồn tại trong quy trình sản xuất lâu dài.
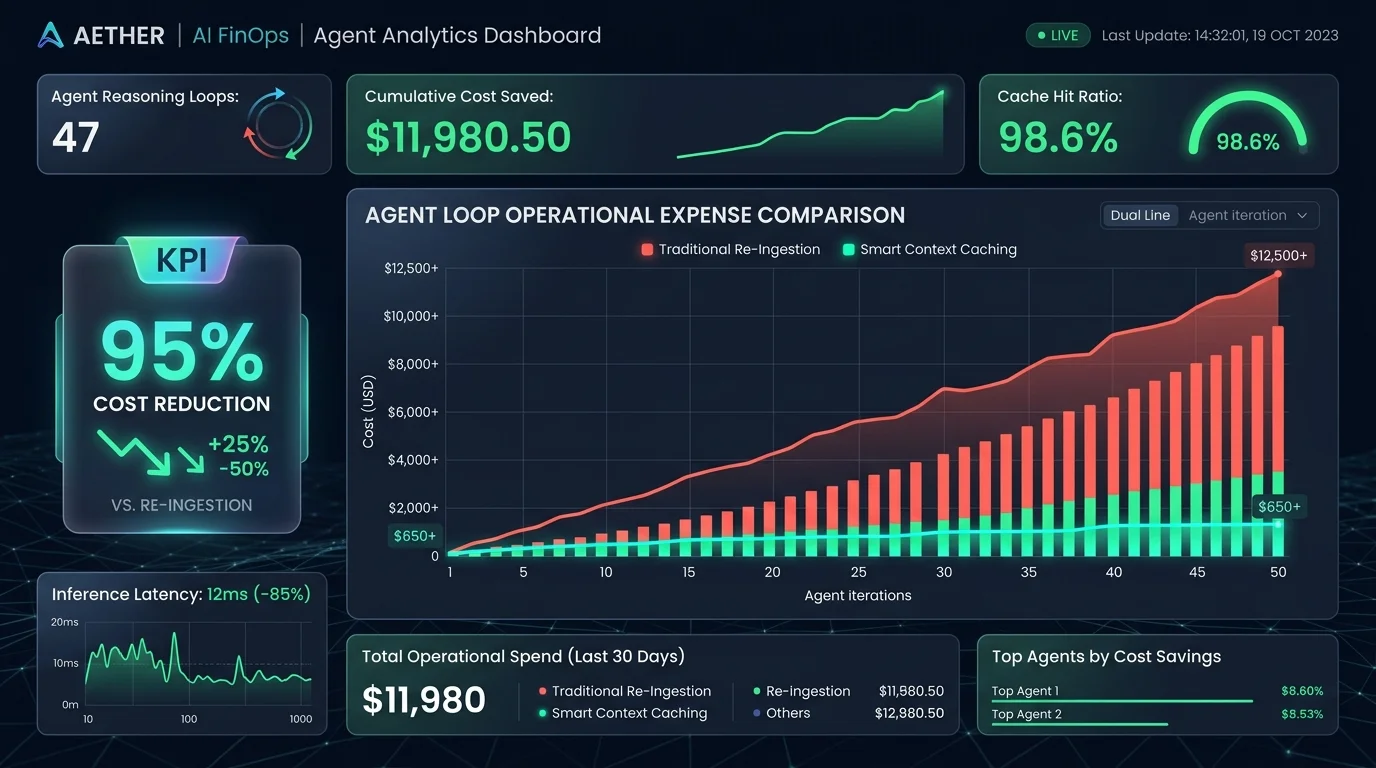
Trong các chu trình tự động hóa, tác nhân AI phải liên tục đọc đi đọc lại kho tài liệu pháp lý hoặc hàng trăm nghìn dòng mã nguồn để đưa ra quyết định tiếp theo. Chính sách giảm giá 95% đối với dữ liệu nạp từ bộ nhớ đệm giúp giảm tải áp lực tài chính nghiêm trọng cho doanh nghiệp. Một phiên làm việc quét lặp 100 lần trên tập dữ liệu 500.000 token trước đây tiêu tốn hàng trăm USD, nay giảm xuống chỉ còn một phần nhỏ chi phí vận hành cơ sở. Khi xây dựng giải pháp tối ưu hóa hạ tầng AI doanh nghiệp, việc kiểm soát đơn giá token đầu vào thông qua cơ chế lưu đệm ngữ cảnh là yếu tố quyết định để duy trì biên lợi nhuận ổn định.
⚠️ Lưu Ý Quan Trọng:
Công thức chi phí chu kỳ tác nhân: Tổng chi phí = (Token đầu vào mới × Giá chuẩn) + (Token bộ nhớ đệm × Giá chuẩn × 0.05) + (Token đầu ra × Giá sinh mã)
Kiểm soát rủi ro ảo giác tích lũy và bài toán đơn giá token đầu ra
Mức giá $10 cho 1 triệu token đầu ra (dự kiến điều chỉnh lên $20 sau giai đoạn thử nghiệm) của Gemini 4 Argon đặt ra yêu cầu kiểm soát chặt chẽ đối với các luồng suy luận dài. Rủi ro lớn nhất trong việc mở rộng dung lượng đầu ra là hiện tượng ảo giác tích lũy. Nếu mô hình đưa ra một giả định kiến trúc sai lệch ở 50.000 token đầu tiên, toàn bộ 950.000 token sinh ra phía sau sẽ trở thành rác kỹ thuật vô giá trị. Doanh nghiệp không chỉ mất chi phí thanh toán cho lượng token lỗi mà còn chịu tổn thất lớn về thời gian chờ phản hồi của hệ thống máy chủ.
Mô Hình Chi Phí Cho Thấy Mức Tiết Kiệm Vượt Bậc Khi Tận Dụng Bộ Nhớ Đệm Ngữ Cảnh Cho Tác Nhân AI
Quy Trình 3 Bước Thẩm Định Mô Hình Gemini 4 Trước Khi Đưa Vào Vận Hành
Việc tích hợp model gemini 4 vào hệ thống lõi của tổ chức cần trải qua các bước kiểm tra nghiêm ngặt nhằm tránh gián đoạn dịch vụ:
Khởi tạo môi trường cách ly (Sandbox Testing): Đưa mô hình vào môi trường thử nghiệm khép kín, cô lập hoàn toàn với cơ sở dữ liệu khách hàng thực tế để đo lường độ trễ mạng và tỷ lệ tiêu hao tài nguyên.
Đo kiểm lỗi logic trên tập dữ liệu chuẩn: Chạy thử nghiệm các tập mã nguồn có sẵn lỗi logic để xác định ngưỡng xảy ra ảo giác tích lũy khi mô hình sinh dữ liệu vượt quá 200.000 token liên tục.
Cân chỉnh ngưỡng ngắt dòng (Circuit Breaker): Thiết lập các điểm kiểm soát tự động để ngắt kết nối API ngay lập tức nếu chuỗi lập luận có dấu hiệu lặp vòng vô tận, bảo vệ ngân sách đám mây khỏi các chi phí phát sinh ngoài dự kiến.
Thắc Mắc Kỹ Thuật Khi Triển Khai Thực Tế Gemini 4 Argon
Cơ chế lưu đệm ngữ cảnh lưu trữ dữ liệu trong bao lâu?
Thời gian lưu đệm mặc định kéo dài từ vài phút đến một giờ tùy thuộc vào cấu hình API và tần suất truy vấn, cho phép tái sử dụng ngữ cảnh mà không cần nạp lại toàn bộ tệp dữ liệu nguồn.
Gemini 4 Argon có phù hợp cho các tác vụ phản hồi tức thời như chatbot không?
Nền tảng này không tối ưu cho chatbot hội thoại ngắn do kiến trúc tập trung vào chuỗi lập luận phức tạp và dung lượng đầu ra lớn, dẫn đến độ trễ khởi tạo phản hồi cao hơn các dòng mô hình thu gọn.
Làm thế nào để hạn chế chi phí phát sinh từ hiện tượng lỗi suy luận dây chuyền?
Thiết lập các mốc kiểm tra trung gian trong luồng dữ liệu để xác thực tính đúng đắn của từng đoạn mã nguồn trước khi cho phép mô hình tiếp tục tạo sinh khối logic tiếp theo.
Doanh nghiệp quy mô nhỏ có nên áp dụng Gemini 4 Argon vào môi trường máy chủ chính thức?
Doanh nghiệp nên bắt đầu ở quy mô thử nghiệm nội bộ, bởi việc kiểm soát ngân sách cho các tác vụ tiêu tốn hàng trăm nghìn token đòi hỏi hệ thống giám sát chi phí thời gian thực hoàn chỉnh.
Lộ Trình Thích Ứng Hạ Tầng Điện Toán Đám Mây Cho Kỹ Sư Hệ Thống
Sự phát triển của các mô hình frontier Gemini 4 Argon đang định hình lại toàn bộ cách thức thiết kế phần mềm tự động hóa. Đội ngũ kỹ sư cần chủ động tái cấu trúc kho dữ liệu để khai thác triệt để ưu thế lưu đệm ngữ cảnh, đồng thời xây dựng các rào chắn kiểm soát lỗi logic chặt chẽ. Khả năng làm chủ bài toán kinh tế điện toán đám mây song song với năng lực kỹ thuật sẽ là thước đo chuẩn xác nhất cho sự thành bại khi đưa trí tuệ nhân tạo vào sản xuất.
ID
CHUYÊN GIA BIÊN SOẠN E-E-A-T
Đội Ngũ Chuyên Gia SEO IDEEN
Bộ Phận Nghiên Cứu & Phát Triển Chiến Lược SEO — IDEEN MEDIA
Tập hợp các chuyên gia giàu kinh nghiệm thực chiến trong lĩnh vực SEO Tổng Thể, Content Marketing và tối ưu tỷ lệ chuyển đổi (CRO). Đã đồng hành phát triển thứ hạng và doanh thu bền vững cho hơn 2.000+ doanh nghiệp hàng đầu trên toàn quốc.